


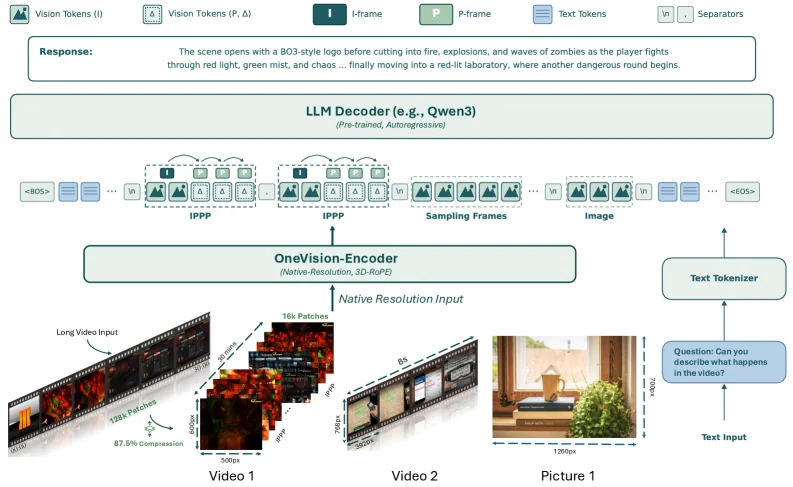
LLaVA-OneVision-2: Towards Next-Generation Perceptual Intelligence
An open 8B model unifying image, long-video and spatial understanding. I worked on the video data engine and evaluation.
@article{an2026llavaonevision2,
  title     = {{LLaVA-OneVision-2: Towards Next-Generation Perceptual Intelligence}},
  author    = {An, Xiang and Xie, Yin and Tang, Feilong and Yan, Yunyao and Tan, Huajie and Zhu, Didi and Chen, Changrui and Zhao, Xiuwei and Qin, Bin and Yang, Kaicheng and Shen, Yifei and Zhang, Yuanhan and Zhang, Kaichen and Zhang, Wenkang and Cheng, Zheng and Zhang, Nansen and Wu, Chunsheng and Ge, Chunjiang and Ran, Zimin and Song, Dehua and Li, Chunyuan and Feng, Shikun and Hu, Ming and Chen, Zhangquan and Niu, Junbo and Li, Bo and Feng, Ziyong and Liu, Ziwei and Ge, Zongyuan and Deng, Jiankang},
  journal   = {arXiv preprint arXiv:2605.25979},
  year      = {2026},
  eprint    = {2605.25979},
  archivePrefix = {arXiv}
}